가장 센 모델이 가장 싼 모델은 아니다, Fable 5.2와 Opus 5.5 작업당 비용
Anthropic은 2026년 11월 9일 Fable 5.2를 내놓으면서 대부분의 코딩과 지식 업무는 Opus 5.5로 시작하라고 권했습니다. 토큰 단가는 두 배이고, Artificial Analysis에서 같은 effort끼리 보면 작업당 평균 비용은 약 1.6배에서 3.2배입니다. 그런데 Fable high는 Opus max보다 쌉니다. 가격표, effort별 비용, 모델별로 앞선 항목, 차단 시 대체 응답 비용을 원문으로 확인하고, 5인에서 30인 회사의 2주 라우팅 시험을 LeanX 제안으로 담았습니다.
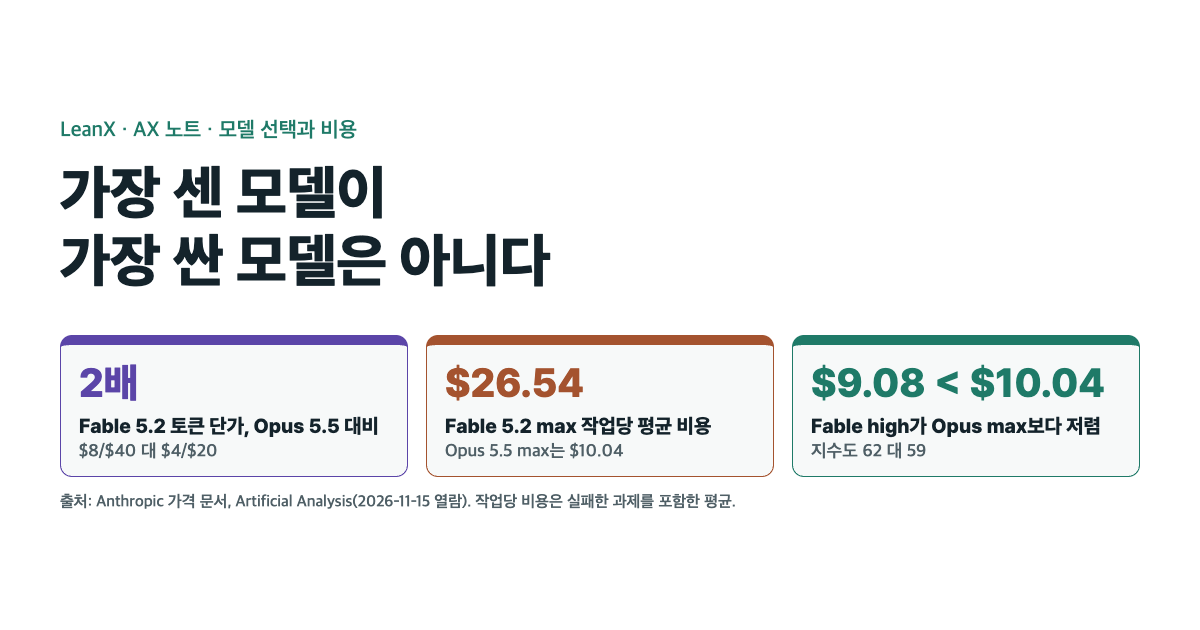
Anthropic은 2026년 11월 9일 Claude Fable 5.2를 발표하면서 "대부분의 코딩과 지식 업무는 Claude Opus 5.5로 시작하라"고 직접 권했습니다. 토큰 단가는 Fable 5.2(입력 100만 토큰당 $8, 출력 $40)가 Opus 5.5의 두 배이고, Artificial Analysis 비교 페이지(2026년 11월 15일 열람)에서 같은 effort끼리 작업당 평균 비용을 놓고 보면 Fable 5.2가 약 1.6배에서 3.2배 높습니다(LeanX 계산). 그런데 Fable 5.2 high($9.08)는 Opus 5.5 max($10.04)보다 싸고 Artificial Analysis 종합 지수도 높습니다(62 대 59). 그래서 작은 회사라면 Opus 5.5를 기본으로 두고, 막히는 작업만 Fable로 올리면서 2주 동안 기록해 보는 방식을 제안합니다.
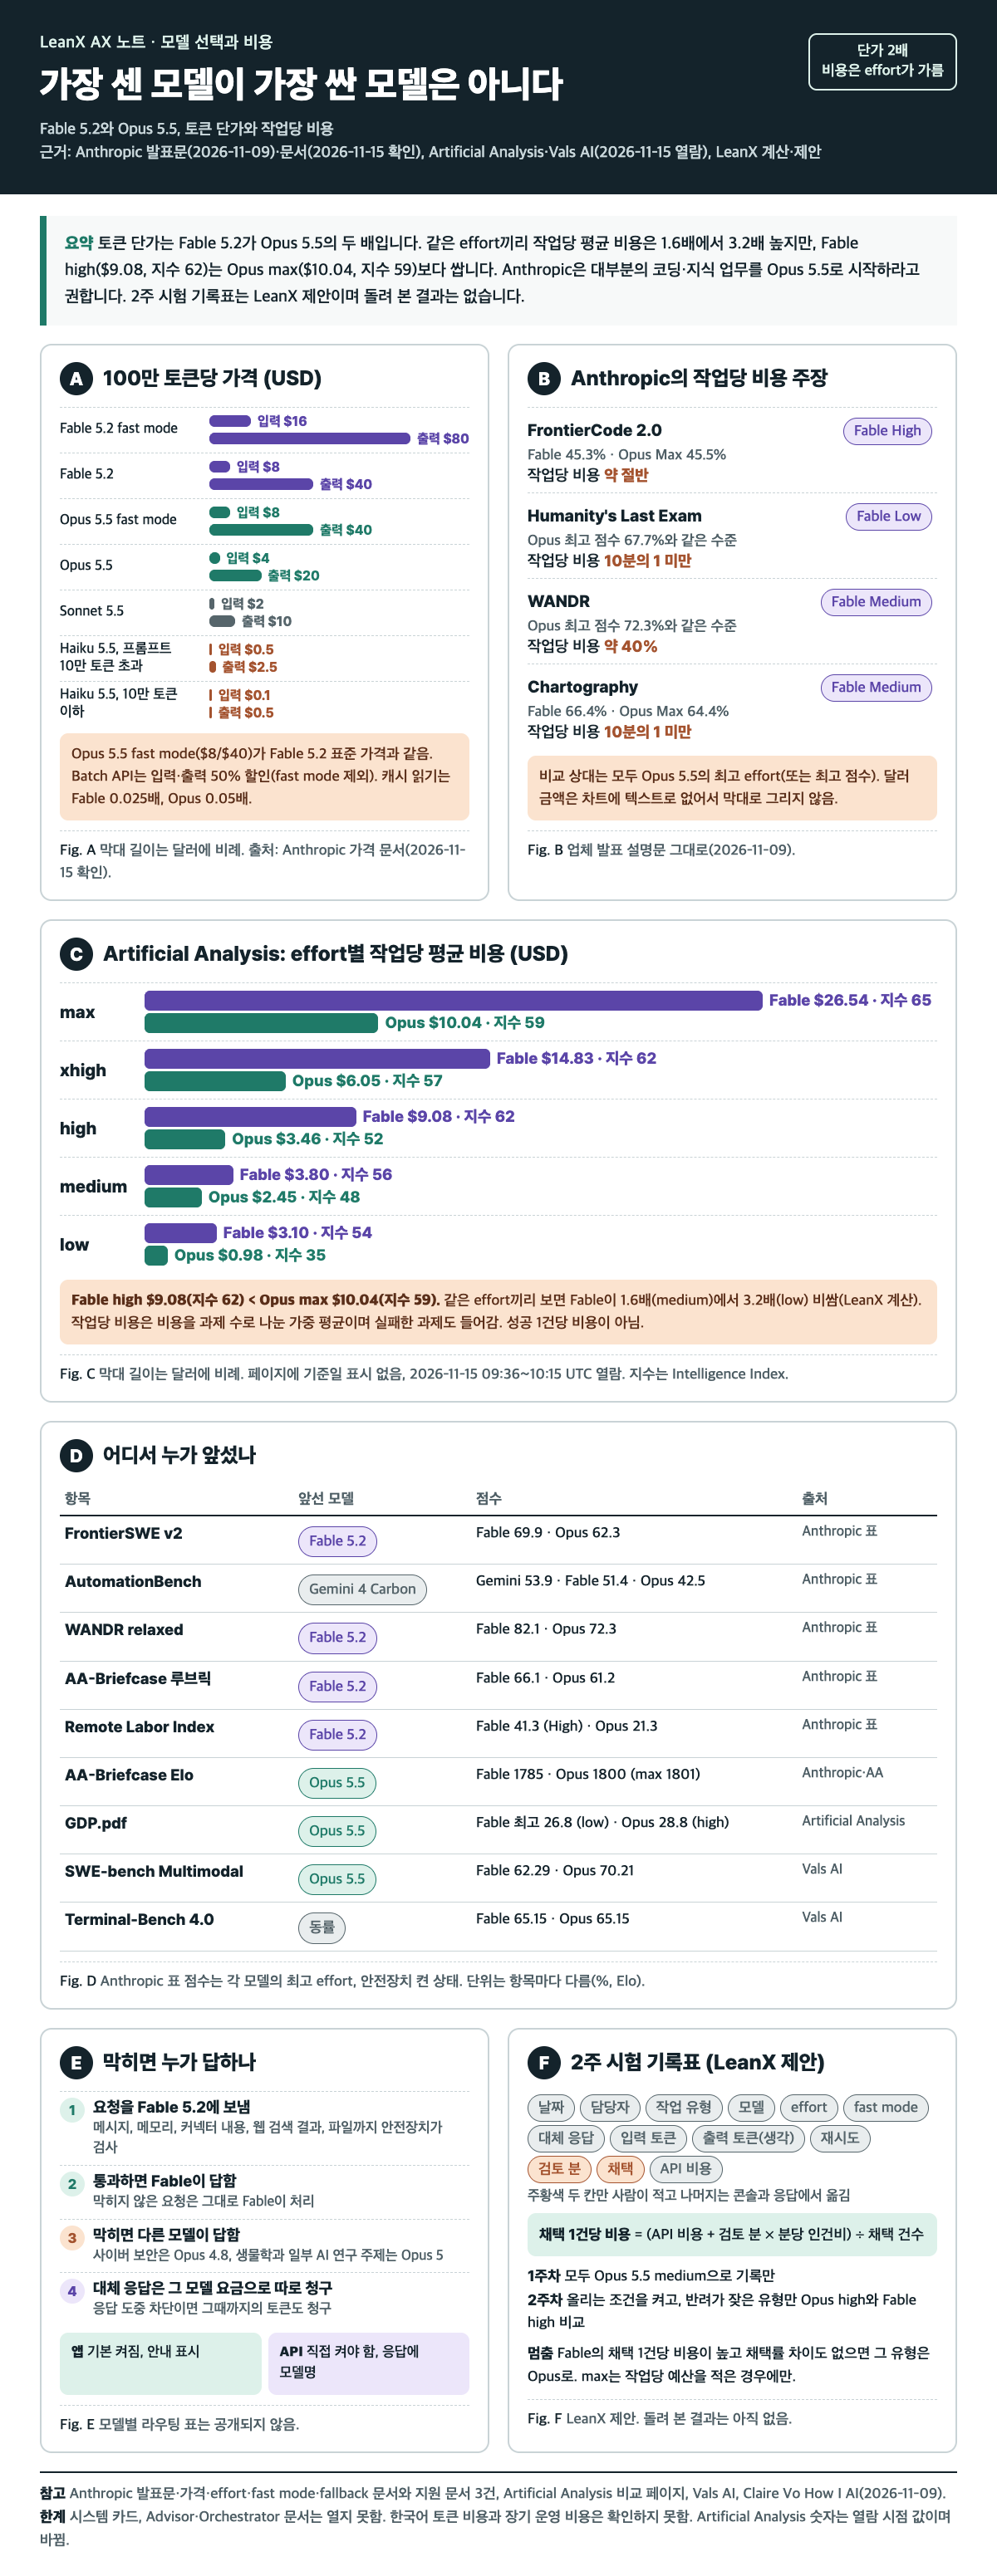
그림: 막대 길이는 달러에 비례합니다(A, C). 출처는 Anthropic 발표문(2026-11-09)과 문서, Artificial Analysis·Vals AI(2026-11-15 열람)이고, F는 LeanX 제안이며 돌려 본 결과는 없습니다.
How I AI 진행자 Claire Vo는 11월 9일 올린 Fable 5.2 리뷰를 "저는 좀 Claude 안티였어요"라는 고백으로 엽니다. 이틀쯤 써 본 뒤로는 이 모델이 좋다고 여러 번 말하고, Fable로 만든 게임도 보여 줍니다. 그 게임 예고 문구에 이런 줄이 있습니다. 팀이 에이전트를 늘려 더 빨리 출시했는데, 재무팀이 토큰 청구서를 보고는 싼 모델로 강등시켜서 이제 쉬운 버그만 고칠 수 있다는 이야기입니다(How I AI, 14:13~14:27).
게임 속 농담인데, 직원 열다섯 명짜리 회사에서 다음 달에 그대로 벌어질 수 있는 장면이기도 합니다. 이 글은 그 에피소드에서 출발하지만 숫자는 Anthropic 발표문과 공식 문서, 독립 측정 사이트에서 가져왔습니다. 크리에이터들의 말은 직접 써 본 사람의 소감으로만 씁니다. 누가 한 말인지(업체, 독립 측정, 개인 경험)와 날짜를 문장마다 붙였습니다.
11월 9일에 무엇이 나왔고, 어떤 문장을 먼저 봐야 하나요?
Anthropic이 Claude Fable 5.2와 Claude Mythos 5.2를 발표했습니다. 둘은 같은 기반 모델입니다. 발표문에서 먼저 읽을 문장은 성능 표보다 아래쪽, "언제 쓰나" 단락에 있습니다.
발표문(2026-11-09)은 Fable과 Mythos가 "가장 야심 차고 열린 형태의 기술 작업"에 가장 잘 맞는다고 쓴 다음, 대부분의 코딩과 지식 업무는 "가장 강력한 일상용 모델(daily driver)"인 Opus 5.5로 시작하라고 권합니다. 일의 범위와 복잡도에 따라 Fable이나 Mythos로 올리거나, Sonnet 5.5나 Haiku 5.5로 내리라는 말이 이어집니다. Fable 5.2를 작은 모델이 어려운 문제를 물어보는 조언자(Advisor)나, 쉬운 일을 작은 모델에 나눠 주는 지휘자(Orchestrator)로 쓸 수도 있다고 덧붙였는데, 이 두 기능의 문서는 이번에 열어 보지 못했습니다.
같은 발표문에 업체 주장 숫자가 몇 개 더 있습니다.
- 가격은 Fable 5.1의 $10/$50에서 $8/$40으로 내렸습니다.
- Fable 5.1보다 출력이 "최대 30%" 빠르다고 합니다. 측정 방법은 적혀 있지 않습니다.
- 선택형 fast mode는 같은 모델의 초당 출력 토큰을 최대 2.5배까지 올립니다. 성능은 같고 값만 비쌉니다(fast mode 문서).
- claude.ai, Claude Code, Cowork 초기 테스트에서 Fable 5.1보다 안전장치 차단이 약 55% 줄었다고 합니다. API가 포함됐는지는 밝히지 않았습니다.
Claire Vo도 에피소드에서 같은 지침을 옮깁니다. Fable 5.2는 Opus 5.5를 대체하지 않고, "그들 말로는" 일상적인 코딩과 지식 업무 대부분이 Opus 5.5의 일이며, 범위와 복잡도, 그리고 자기가 보기엔 창의성이 필요할 때 Fable이 빛난다는 내용입니다(2:54~3:06). 에피소드 페이지는 두 모델 사이에 일을 어떻게 나누는지 다룬다고 소개하지만, 제가 읽은 영상 자막에 그런 규칙표는 없었습니다. 그가 실제로 일을 어떻게 나누는지는 이 글도 모릅니다.
토큰 단가는 얼마이고, 왜 그 값이 작업당 비용이 되지 않나요?
Fable 5.2의 토큰 단가는 Opus 5.5의 정확히 두 배입니다. 하지만 일 하나를 끝내는 데 드는 돈은 단가에 토큰 수를 곱한 값이고, 토큰 수는 effort 설정, 생각(thinking) 토큰, 재시도에 따라 몇 배씩 움직입니다. 사람이 결과를 검토하는 시간은 청구서에 아예 안 잡힙니다.
100만 토큰당 가격 (Anthropic 가격 문서, 2026-11-15 확인)
| 모델 | 입력 | 출력 | 캐시 읽기 | 메모 |
|---|---|---|---|---|
| Fable 5.2 | $8 | $40 | $0.20 (기본 입력가의 0.025배) | Mythos 5.2도 같은 값 |
| Fable 5.2 fast mode | $16 | $80 | 캐시 배수가 fast mode 가격 위에 붙음 | Batch API와 같이 못 씀 |
| Opus 5.5 | $4 | $20 | $0.20 (0.05배) | fast mode는 $8/$40 |
| Sonnet 5.5 | $2 | $10 | $0.10 | |
| Haiku 5.5, 프롬프트 10만 토큰 이하 | $0.10 | $0.50 | $0.01 | |
| Haiku 5.5, 프롬프트 10만 토큰 초과 | $0.50 | $2.50 | $0.05 | 캐시 읽기도 프롬프트 길이에 포함 |
급하지 않은 일은 Batch API로 보내면 입력과 출력 모두 50% 할인됩니다. 눈여겨볼 줄이 하나 있습니다. Opus 5.5 fast mode($8/$40)가 Fable 5.2 표준 가격과 같습니다. 같은 토큰 단가로 더 빠른 Opus를 살지, 더 센 Fable을 살지 고르는 셈입니다.
단가와 작업당 비용이 어긋나는 이유는 네 가지입니다.
1. effort 기본값이 앱과 API에서 다릅니다. effort 문서에 따르면 Fable 5.2는 low, medium, high, xhigh, max 다섯 단계를 지원하고 API 기본값은 high입니다. 발표문은 Claude 앱과 Claude Code의 기본값을 Medium이라고 적었습니다. Opus 5.5와 Haiku 5.5의 기본값은 medium입니다. Claude Code에서 써 보고 괜찮아서 API로 옮긴 팀은 설정을 따로 적지 않는 한 한 단계 높은 effort 값을 내게 된다는 게 LeanX의 읽기입니다.
2. 생각 토큰은 끌 수 없습니다. Fable 5.2는 적응형 생각(adaptive thinking)이 항상 켜져 있어서 effort가 생각의 깊이와 비용을 조절하는 가장 큰 손잡이입니다. Artificial Analysis 비교 페이지에 들어 있는 데이터로 보면 Fable 5.2 max는 과제 하나에 평균 273,776개의 출력 토큰을 쓰고, 그중 192,701개가 생각 토큰입니다. Opus 5.5 max는 173,313개입니다. Hacker News의 한 사용자(rgbrenner)는 이 값을 Fable 5.1의 118k와 비교해 "작업당 비용이 두 배가 됐다"고 썼는데, 이건 Fable 5.1과 5.2를 비교한 숫자이고, 5.1의 118k는 제가 연 페이지에서 따로 확인하지 못했습니다.
3. 재시도와 실패도 돈입니다. Simon Willison은 펠리컨 SVG 프롬프트 하나를 다섯 effort로 돌렸는데, max에서는 "128,000을 생각하는 데 쓰고 토큰이 바닥나서" 그림을 아예 돌려주지 못했다고 썼습니다(아래 '직접 써 본 사람들' 단락 참고). 안전장치에 막히는 경우에도 응답 도중 막히면 그때까지의 토큰은 청구됩니다.
4. 검토 시간은 어느 표에도 없습니다. 벤치마크 비용도 API 청구서도 사람이 결과를 읽고 고치는 시간을 세지 않습니다. 모델이 자기 결과물의 부족함을 잘 못 알아챈다면 그 몫은 사람 검토로 넘어옵니다.
Anthropic 문서도 effort를 아끼라는 쪽입니다. high에서 시작하고, 효과를 잰 가장 어려운 장시간 코딩과 에이전트 작업에만 xhigh로 올리고, max는 모델의 한계를 재거나 "시간과 토큰이 문제 되지 않는 드문 작업"에만 쓰라고 합니다. max에서는 모델이 토큰 비용을 고려하지 않고 성능만 쫓는다고도 적혀 있습니다.
Anthropic의 "절반 비용"과 Artificial Analysis의 숫자는 어떻게 같이 읽나요?
Anthropic의 비용 주장은 effort를 낮춘 Fable 5.2와 최고 effort의 Opus 5.5를 비교합니다. Artificial Analysis는 같은 effort끼리, 시도한 모든 과제에 쓴 돈의 평균을 보여 줍니다. 비교 기준이 다르니 두 숫자가 동시에 맞을 수 있습니다.
Anthropic 주장 (업체 발표, 2026-11-09, 차트 설명문 기준)
| 벤치마크 | Fable 5.2 설정과 점수 | 비교 대상 | Anthropic이 밝힌 작업당 비용 |
|---|---|---|---|
| FrontierCode 2.0 | High, 45.3% | Opus 5.5 Max, 45.5% | 약 절반 |
| Humanity's Last Exam(도구 사용) | Low, 점수 미공개 | Opus 5.5 최고 점수 67.7% | 10분의 1 미만 |
| WANDR(relaxed score) | Medium, 점수 미공개 | Opus 5.5 최고 점수 72.3% | 약 40% |
| Chartography(도구 없음) | Medium, 66.4% | Opus 5.5 Max, 64.4% | 10분의 1 미만 |
넷 모두 effort 단계를 밝혔다는 점은 좋습니다. 다만 차트의 점들에는 텍스트 값이 없어서 실제 달러 금액은 확인할 수 없었고, FrontierCode를 뺀 세 차트(HLE, WANDR, Chartography)는 가로축이 "시도당 비용"인데 설명문은 "작업당 비용"이라고 씁니다. FrontierCode에서 Fable 5.2의 최고 기록 49.1%는 Xhigh에서 나온 값입니다.
Artificial Analysis 비교 페이지 (독립 측정, 2026-11-15 09:36~10:15 UTC 열람, 페이지에 기준일 표시 없음)
| effort | Fable 5.2 지수 | Fable 5.2 작업당 비용 | Opus 5.5 지수 | Opus 5.5 작업당 비용 | 비용 배율(LeanX 계산) |
|---|---|---|---|---|---|
| max | 65 | $26.54 | 59 | $10.04 | 2.6배 |
| xhigh | 62 | $14.83 | 57 | $6.05 | 2.5배 |
| high | 62 | $9.08 | 52 | $3.46 | 2.6배 |
| medium | 56 | $3.80 | 48 | $2.45 | 1.6배 |
| low | 54 | $3.10 | 35 | $0.98 | 3.2배 |
여기서 "작업당 비용"이 무엇인지부터 짚어야 합니다. Artificial Analysis는 평가별 토큰 비용을 과제 수로 나누고 지수 가중치로 평균 낸다고 설명합니다. 실패한 과제도 분모에 들어가니, 성공한 결과 하나당 비용은 아닙니다. 시간도 실제 벽시계 측정이 아니라 토큰 수를 출력 속도로 나눈 추정치입니다. 숫자도 움직입니다. 11월 10일 Sebastien Dubois가 인용한 Fable max 과제당 시간은 약 46분이었는데, 제가 연 시점에는 44.5분이었습니다.
표를 읽는 법은 이렇습니다.
- Fable 5.2 high는 Opus 5.5 max보다 지수(62 대 59), 비용($9.08 대 $10.04), 추정 시간(15.5분 대 25.4분) 셋 다 낫습니다. 다만 같은 페이지의 AA-Briefcase와 GDP.pdf에서는 Opus max가 더 높습니다. 평소 Opus를 max로 돌리던 일이라면 Fable high가 더 쌀 수 있습니다. Anthropic의 FrontierCode 주장과 같은 방향입니다.
- Opus 5.5 medium이나 high로 충분한 일이라면 Opus가 쌉니다. Artificial Analysis도 페이지 요약에서 작업당 비용이 가장 낮은 설정으로 Opus 5.5 low($0.98)를 꼽습니다.
- Fable 5.2 max는 지수 1위지만 비용 순위는 79개 중 79위입니다. 모델 페이지는 이 설정을 "비슷한 가격대 모델과 비교하면 특히 비싸고, 과제당 눈에 띄게 느리며, 매우 장황하다"고 평합니다.
Hacker News의 다른 사용자(Aurornis)는 이 사이트가 기본으로 max를 보여 준다고 지적하면서, Fable 5.2 medium은 Opus 5.5 high나 xhigh와 견줘 꽤 매력적이지만 max는 "돈에 불을 붙이는 좋은 방법"으로 보인다고 썼습니다(HN 댓글). 비용 계산 방식이 궁금하다면 AI의 승인 결과당 원가를 보는 방법도 같이 보시면 좋습니다.
Fable 5.2는 어떤 항목에서 이기고, 어디서 지나요?
Anthropic 발표문의 표에서 Fable 5.2는 대부분의 행에서 1위지만 전부는 아닙니다. 업무 자동화 벤치마크는 Google Gemini 4 Carbon이, 지식 업무 문서 평가 일부는 Opus 5.5가 앞섭니다.
| 항목 | Fable 5.2 | Opus 5.5 | 앞선 모델 | 출처 |
|---|---|---|---|---|
| FrontierSWE v2 | 69.9% | 62.3% | Fable 5.2 | Anthropic 표 |
| AutomationBench | 51.4% | 42.5% | Gemini 4 Carbon 53.9% | Anthropic 표 |
| WANDR(relaxed) | 82.1% | 72.3% | Fable 5.2 | Anthropic 표 |
| OSWorld 2.1 | 89.3% | 87.2% | Fable 5.2 | Anthropic 표 |
| Remote Labor Index | 41.3% (High) | 21.3% | Fable 5.2 | Anthropic 표 |
| AA-Briefcase v1.1 루브릭 | 66.1% | 61.2% | Fable 5.2 | Anthropic 표 |
| AA-Briefcase v1.1 Elo | 1785 | 1800 | Opus 5.5 | Anthropic 표 |
| AA-Briefcase v1.1 Elo, max | 1785 | 1801 | Opus 5.5 | Artificial Analysis |
| GDP.pdf, 각 모델 최고 점수 | 26.8% (low) | 28.8% (high) | Opus 5.5 | Artificial Analysis |
| SWE-bench Multimodal | 62.29% | 70.21% | Opus 5.5 | Vals AI |
| Terminal-Bench 4.0 | 65.15% | 65.15% | 동률 | Vals AI |
Anthropic 표의 점수는 따로 적지 않은 한 각 모델의 최고 effort이고 안전장치가 켜진 상태입니다. 회사 스스로도 Fable 5.2를 "평가한 거의 모든 능력에서" Opus 5.5보다 한 단계 위라고 표현했습니다. Artificial Analysis의 GDP.pdf에서는 Opus 5.5가 high에서 낸 28.8%가 Fable 5.2의 어떤 effort보다 높고, Fable은 오히려 low(26.8%)가 max(24.2%)보다 높게 나왔습니다. Vals AI는 Fable 5.2를 high effort로 돌려 자체 지수 71.31%로 1위에 올렸고, Sonnet 5.5(70.85%)가 그 뒤에 있습니다. 테스트당 비용은 $17.94입니다.
지식 업무 문서 평가는 지표마다 엇갈립니다. 루브릭 점수는 Fable이 앞서고, Elo와 GDP.pdf는 Opus가 앞섭니다. 그래서 LeanX는 보고서나 브리핑 같은 산출물을 Opus로 시작해 두고 표본만 Fable과 비교해 보자고 봅니다. 큰 코딩 작업, 에이전트 검색, 장시간 원격 업무 쪽에서는 Fable의 차이가 더 크게 나옵니다.
직접 써 본 사람들은 어디서 엇갈렸나요?
출시 당일 나온 소감은 열광부터 경고까지 넓습니다. 공통점은 하나입니다. 높은 effort의 시간과 토큰을 공짜로 여긴 사람은 없었습니다.
| 누가, 언제 | 어떻게 써 봤나 | 한 말 | 읽을 때 주의할 점 |
|---|---|---|---|
| Claire Vo, How I AI (11-09) | 이틀 정도 사용, 출시 전 접근으로 보임 | 아주 빠르고 창의 작업에 좋지만 웹 디자인은 "정말 형편없다". 좋은 브랜드나 스타일 가이드를 주면 취향이 좋아진다고도 함. 디자인 쪽은 Opus 5.5와 짝지어 쓸 수도 있다고 말함. 자기 테스트에서는 안전장치에 걸린 적이 없었다고 함 | 스스로 Fable 5.2를 아주 좋아한다고 밝힌 사용자의 소감 |
| Simon Willison (11-09) | 펠리컨 SVG 프롬프트 하나를 다섯 effort로 | 가장 좋은 결과는 xhigh. max는 "running out of tokens after spending 128,000 thinking about them". Opus 5.5에서도 본 버그라고 씀 | 프롬프트 하나의 결과 |
| Ethan Mollick (11-09) | 출시 전 사용, 장기 프로젝트 여럿 | "자기 작업이 충분히 좋지 않다는 걸 아는 것이 전문가의 큰 부분인데, Fable이 가장 덜 믿음직하게 하는 부분이 그것" | 검토 시간을 사람 몫으로 잡아야 한다는 신호 |
| Matt Shumer (11-09) | 출시 전 테스트 버전 여럿 | 높은 effort는 "매우, 매우 느리다". low나 medium이면 거의 다 되고 extra high는 가장 까다로운 문제에만 | 방향을 잡아 주는 건 여전히 사람 몫이라고도 씀 |
| Hacker News postalcoder (11-09) | 출시 직후 사용 | "for ordinary coding tasks"에서는 Fable 5.2와 Opus 5.5의 차이를 구별하기 어렵다고 함 | 익명 사용자 한 명의 댓글 |
| Theo, t3.gg (11-10) | 영상 리뷰 | Opus 5.5는 자기가 모든 일에 쓰는 모델이 됐지만 Fable 5.2는 "내가 모든 일에 쓸 모델은 아니다" | YouTube 자동 자막으로 확인 |
Claire Vo의 웹 디자인 평가(16:54~17:00)와 Opus 5.5 병행 언급(17:34~17:45)은 한 사람의 이틀짜리 경험입니다. 그래도 작은 회사가 랜딩 페이지나 화면 작업을 Fable에 맡기기 전에 한 번쯤 비교해 볼 이유로는 충분합니다.
보안이나 바이오 작업이 막히면 어떤 모델이 답하고, 비용은 어떻게 되나요?
Fable 5.2는 위험도 높은 사이버 작업과 연구용 생물학 작업 대부분을 막고, 막힌 질문에는 다른 모델이 답합니다. 사이버 보안은 Opus 4.8, 생물학은 Opus 5입니다. 앱에서는 기본으로 켜져 있고, API에서는 직접 켜야 하며, 대체 응답은 따로 청구됩니다.
발표문은 침투 테스트, 익스플로잇 생성, 바이너리 기반 취약점 작업을 막는 대상으로 들고, 비표준 가속기의 커널 개발 같은 일부 AI 연구 주제도 Opus 5로 넘긴다고 적었습니다. 지원 문서에 따르면 검사는 최근 메시지만 보지 않고 메모리, 커넥터 내용, 웹 검색 결과, 파일까지 모델이 읽는 모든 것을 봅니다.
| 구분 | Claude 앱 | API |
|---|---|---|
| 자동 전환 | 기본으로 켜짐. 설정에서 끌 수 있음 | 직접 켜야 함: fallbacks: "default"와 베타 헤더 server-side-fallback-2026-07-01 |
| 사용자에게 보이나 | 모델이 바뀌었다는 안내와 답한 모델 이름이 붙음. 이후 대화는 Opus에 머묾 | 응답에 답한 모델 이름과 fallback 블록이 표시됨. 같은 대화의 다음 요청은 약 1시간 동안 그 모델로 바로 감 |
| 대체 응답 비용 | Opus 응답은 그 모델 요금으로 따로 청구, 캐시 미스분은 크레딧으로 보전 | 대체 요청도 그 모델 요금으로 청구, 캐시 미스분 크레딧 있음 |
| 막힌 요청 비용 | 출력 전 차단은 생물학, 증류, 최전선 LLM 개발 분류만 청구 | 사이버는 출력 전 차단 시 청구 없음. 응답 도중 차단이면 그때까지의 토큰은 청구 |
API 문서는 모델별 라우팅 표를 공개하지 않는다고 밝힙니다. Opus 4.8과 Opus 5라는 이름은 발표문과 지원 문서에서 나온 것입니다.
LeanX의 의견은 이렇습니다. 보안 점검이나 생물 관련 자료를 자주 다루는 팀이라면, Fable에 보냈다가 막히고 Opus 답을 따로 사는 경로보다 처음부터 Opus로 보내는 편이 비용을 읽기 쉽습니다. 하나 더 있습니다. Fable 5.2는 30일 데이터 보관이 필요하고, Anthropic의 명시적 승인 없이는 데이터 무보관(ZDR) 조건에서 쓸 수 없습니다. 고객사와 데이터 보관 조건을 계약한 회사라면 성능보다 이 조건을 먼저 보셔야 합니다.
5~30명 회사는 2주 동안 무엇을 재 보면 될까요?
여기서부터는 LeanX의 제안입니다. LeanX가 돌려 본 결과는 아직 없습니다. 기본 모델은 Opus 5.5 medium으로 두고, 작업 유형별로 올리는 조건을 미리 적고, 2주 동안 "채택된 결과 1건당 비용"을 잽니다.
작업 유형별 시작 모델 (LeanX 제안)
| 작업 유형 | 시작 모델과 effort | 올리는 조건 | 근거 |
|---|---|---|---|
| 일상 코딩, 문서 초안, 리서치 요약 | Opus 5.5 medium | 같은 작업이 두 번 반려되면 Opus high, 그래도 안 되면 Fable 5.2 high | Anthropic 권고, Opus 기본값 |
| 대량 분류, 추출, 번역 초벌 | Haiku 5.5 또는 Sonnet 5.5, 급하지 않으면 Batch | 표본 검수에서 기준 미달이면 한 단계 위 | 가격표, Batch 50% 할인 |
| 큰 이관, 원인 모를 버그, 30분 넘는 에이전트 작업 | Fable 5.2 high | xhigh는 효과를 잰 작업 유형에만 | effort 문서, FrontierCode 설명문 |
| 보고서, 브리핑 같은 지식 업무 산출물 | Opus 5.5 | 2주차에 표본만 Fable과 비교 | AA-Briefcase, GDP.pdf 결과 |
| 웹 화면, 랜딩 페이지 | Opus 5.5와 브랜드 가이드 | Fable을 쓰면 스타일 가이드를 함께 줌 | Claire Vo의 소감(한 사람의 경험) |
| 보안 점검, 생물 관련 | Fable을 거치지 않고 Opus로 | 해당 없음 | 차단과 대체 응답 별도 청구 |
| max effort | 기본으로 쓰지 않음 | 작업당 예산을 미리 적어 둔 경우에만 | effort 문서의 max 안내 |
기록표 열 (LeanX 제안)
날짜, 담당자, 작업 유형, 모델, effort, fast mode 여부, 대체 응답 여부와 답한 모델, 입력 토큰, 출력 토큰과 그중 생각 토큰, 재시도 횟수, 사람 검토 시간(분), 채택 여부, API 비용. 열이 많아 보여도 토큰과 비용은 콘솔이나 응답에서 그대로 옮기면 되고, 사람이 적을 건 검토 시간과 채택 여부 두 칸입니다.
잴 숫자 하나: 채택된 결과 1건당 비용
작업 유형마다 (API 비용 합계 + 검토 시간 × 분당 인건비) ÷ 채택된 결과 수로 계산합니다. Artificial Analysis가 시도한 모든 과제로 나누는 것과 달리, 이 지표는 실제로 쓴 결과만 분모에 넣습니다. 그래서 싸지만 자주 반려되는 설정은 비싸게, 비싸지만 한 번에 통과하는 설정은 싸게 나올 수 있습니다.
2주 진행 방식 (LeanX 제안)
- 1주차: 모두 기본값(Opus 5.5 medium)으로 일하면서 기록만 합니다. 반려가 잦은 작업 유형이 어디인지 보는 주입니다.
- 2주차: 위 작업 유형별 올리는 조건을 켭니다. 반려가 잦았던 유형에서는 작업 몇 건을 골라 Opus 5.5 high와 Fable 5.2 high로 둘 다 돌려 보고 채택 1건당 비용을 비교합니다.
멈추는 규칙 (LeanX 제안)
- 어떤 작업 유형에서 Fable의 채택 1건당 비용이 Opus보다 높고 채택률 차이도 없으면, 그 유형은 Opus로 돌립니다.
- 대체 응답이 반복해서 나오는 작업 유형은 처음부터 Opus로 보냅니다.
- max 예산을 한 번이라도 넘기면 그 주에는 max를 쓰지 않습니다.
- 검토 시간이 늘었는데 채택률이 그대로라면 effort를 한 단계 내립니다.
예산 상한과 정지 버튼을 어디에 둘지는 에이전트 한도·정지 통제표 글의 방식을 그대로 가져다 쓸 수 있고, "채택"의 기준을 미리 정하는 법은 AI 에이전트 출시 전 평가 20개 체크리스트 글과 같습니다. 30분 넘게 맡기는 작업의 체크포인트는 AI에게 오래 일을 맡기는 조건 글을 참고하세요.
날짜가 걸린 메모: 프로모션 종료일. 지원 문서에 따르면 Pro 요금제와 Team 요금제 표준 좌석은 2026년 11월 16일 오후 11시 59분(미국 태평양 시간)까지 주간 사용 한도의 최대 50%를 Fable 모델에 추가 비용 없이 쓸 수 있습니다. 한국 시간으로는 11월 17일 오후 4시 59분입니다(LeanX 환산). 그 뒤 이 요금제에서 Fable은 사용 크레딧으로 돌아갑니다. Max, Ultra, 프리미엄 좌석에 준 Fable 리셋은 2027년 3월 8일에 만료됩니다. 지원 문서는 Fable 모델이 다른 모델보다 사용 한도를 빨리 쓴다고도 경고합니다. 프로모션 주간에 써 본 느낌으로 2주 시험의 기준선을 잡지는 마세요.
이 글이 확인하지 못한 것
- Fable 5.2와 Mythos 5.2 시스템 카드(System Card)는 열지 않았습니다. 벤치마크 방법론은 그 문서에 있다고 발표문이 밝힙니다.
- 조언자(Advisor)와 지휘자(Orchestrator) 역할의 공식 문서는 열지 않았습니다.
- Anthropic 차트의 effort별 점과 달러 금액은 페이지에 텍스트로 없어서, "절반", "10분의 1 미만", "약 40%"의 실제 금액은 모릅니다. "최대 30% 빠르다"의 측정 방법도 적혀 있지 않습니다.
- 한국어 문서의 토큰 비용은 확인하지 못했습니다. 가격 문서는 Claude 4.7 이후 모델의 새 토크나이저가 같은 텍스트에 약 30% 더 많은 토큰을 만든다고만 적었고, 이 값은 이전 토크나이저와 비교한 것입니다. 한국어만 따로 잰 숫자는 없습니다.
- 실제 회사 업무에서 몇 달 동안 쓴 비용은 찾지 못했습니다. Artificial Analysis 숫자는 벤치마크 과제 묶음의 평균이고, 출시 이후에도 바뀌고 있습니다.
- Claire Vo가 두 모델 사이에 일을 실제로 어떻게 나누는지는 모릅니다. 영상 자막에 규칙표가 없었습니다.
- Signal65의 Fable 5.2 수치는 설명 없는 위젯 데이터로만 보였고 상태가 "assumed"로 표시돼 있어 쓰지 않았습니다.
- Fable 5.1의 과제당 118k 토큰은 제가 본 곳이 Hacker News 댓글과 이를 옮긴 Dubois 글뿐이고, 제가 연 Artificial Analysis 페이지에는 없었습니다.
- Theo의 후속 영상들, Dan Shipper의 X 게시물, 몇몇 비교 영상은 요약이나 제목만 봤기 때문에 인용하지 않았습니다.
- 안전장치 차단이 약 55% 줄었다는 초기 테스트에 API가 포함됐는지, 표본이 얼마인지는 발표문에 없습니다.
우리 팀의 어떤 작업이 기록표에 들어갈 만한지부터 막막하다면 30문항 무료 AX 진단으로 먼저 점검해 볼 수 있습니다.
출처
- Anthropic, Claude Fable 5.2 and Claude Mythos 5.2 발표문 (2026-11-09, 11-11 일부 수정, 2026-11-15 확인)
- Anthropic, Pricing 문서 (2026-11-15 확인)
- Anthropic, Effort 문서 (2026-11-15 확인)
- Anthropic, Claude Fable 5.2 모델 개요 (2026-11-15 확인)
- Anthropic, Fast mode 문서 (2026-11-15 확인)
- Anthropic, Refusals and fallback 문서 (2026-11-15 확인)
- Claude 지원 문서, Claude Fable 5.2 launch offers (2026-11-15 확인)
- Claude 지원 문서, Claude Fable models on your plan (2026-11-15 확인)
- Claude 지원 문서, Why Claude switched models in your conversation with Fable models (2026-11-15 확인)
- Artificial Analysis, Claude Fable 5.2 vs Claude Opus 5.5 비교 (기준일 표시 없음, 2026-11-15 UTC 열람)
- Artificial Analysis, Claude Fable 5.2 모델 페이지 (2026-11-15 UTC 열람)
- Artificial Analysis, Intelligence Benchmarking 방법론 (2026-11-15 UTC 열람)
- Vals AI, Claude Fable 5.2 (2026-11-15 확인)
- Claire Vo, How I AI: Claude Fable 5.2 영상 (2026-11-09, 출발점)
- Lenny's Newsletter, Claude Fable 5.2 review: fast, creative, and finally not annoying (2026-11-09)
- Simon Willison, Release llm-anthropic 0.31 (2026-11-09)
- Ethan Mollick, Fable 5.2 and Jagged AGI (2026-11-09)
- Matt Shumer, My Fable 5.2 Review (2026-11-09)
- Hacker News, Claude Fable 5.2 and Mythos 5.2 스레드의 postalcoder 댓글 (2026-11-09)
- Hacker News, Artificial Analysis results 스레드 (rgbrenner, Aurornis 댓글)
- Sebastien Dubois, Claude Fable 5.2: cheaper per token, twice the cost per task at max effort (2026-11-10)
- Theo, Nobody Is Competing With Anthropic (2026-11-10, 자동 자막으로 확인)
자주 묻는 질문
Fable 5.2와 Opus 5.5 중 무엇을 기본 모델로 써야 하나요?
Anthropic은 2026년 11월 9일 발표문에서 대부분의 코딩과 지식 업무는 Opus 5.5로 시작하고, 범위와 복잡도가 클 때 Fable 5.2로 올리라고 권했습니다. Artificial Analysis 비교에서도 같은 effort끼리는 Opus 5.5의 작업당 평균 비용이 낮았습니다. 큰 이관이나 장시간 에이전트 작업처럼 막히는 일만 Fable로 올려 보기를 LeanX는 제안합니다.
Fable 5.2 effort는 어느 단계로 쓰는 게 좋나요?
Anthropic effort 문서는 high에서 시작하고, 효과를 잰 가장 어려운 장시간 작업에만 xhigh를 쓰며, max는 한계 측정이나 시간과 토큰이 문제 되지 않는 드문 작업에만 쓰라고 합니다. API 기본값은 high, Claude 앱과 Claude Code 기본값은 Medium입니다. Artificial Analysis에서 Fable 5.2 max의 작업당 평균 비용은 $26.54였습니다(2026-11-15 열람).
Fable 5.2가 요청을 막으면 비용이 두 번 나가나요?
그럴 수 있습니다. 막힌 사이버 보안 요청은 Opus 4.8이, 생물학 요청은 Opus 5가 답하고, 그 응답은 해당 모델 요금으로 따로 청구됩니다. 응답 도중 막혔거나 생물학처럼 청구 대상 분류라면 막힌 요청도 함께 청구됩니다. Claude 앱에서는 자동 전환이 기본이고, API에서는 fallbacks 설정과 베타 헤더로 직접 켜야 합니다.
Artificial Analysis의 작업당 비용은 성공한 작업 기준인가요?
아닙니다. Artificial Analysis는 평가별 토큰 비용을 과제 수로 나누고 지수 가중치로 평균 낸다고 설명하므로, 실패한 과제도 분모에 들어갑니다. 페이지에 기준일이 표시돼 있지 않고 숫자가 출시 뒤에도 바뀌고 있어 열람 날짜를 같이 적어야 합니다. 회사 안에서는 채택된 결과 1건당 비용을 따로 재는 편이 낫습니다.
어떤 작업을 어느 모델로 보낼지, 채택된 결과 1건당 비용을 어떻게 잴지 우리 팀 업무에 맞춰 같이 정해 보세요.
무료 AX 진단