AI 벤치마크를 업무 파일럿으로 바꾸는 법: Opus 5.5와 GPT-6 Sol
벤치마크의 58점과 48점은 구매 결론이 아닙니다. Opus 5.5와 GPT-6 Sol을 실제 업무에 도입할 때 20~50개 사례, 비용, 재작업, 거절, 승인 흐름으로 검증하는 법을 안내합니다.
AI 모델 출시 주간에는 숫자가 넘칩니다. Claude Opus 5.5와 GPT-6 Sol도 코딩, 컴퓨터 사용, 전문 업무, 비용 효율에 대한 많은 표를 함께 공개했습니다. 이 표는 출발점으로 유용합니다. 하지만 우리 회사의 고객 문의, 내부 문서, 코드베이스, 결재 규칙, 보안 정책, 담당자의 검토 시간과 동일하지는 않습니다.
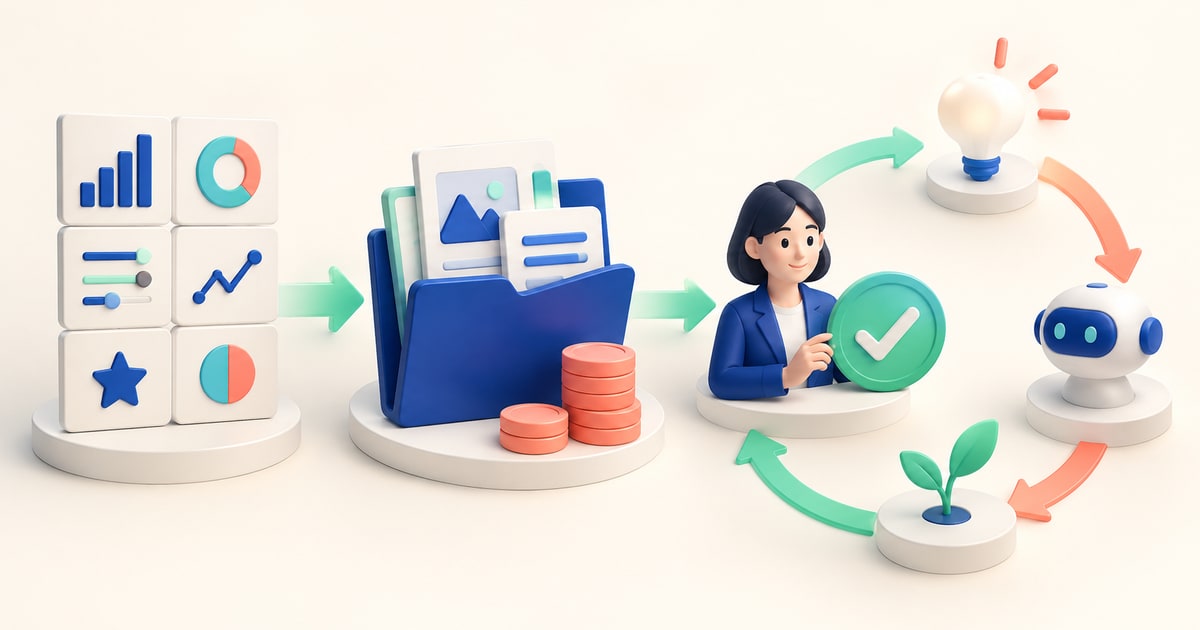
진짜 질문은 ‘58점 모델과 48점 모델 중 무엇을 살까’가 아닙니다. ‘우리 팀의 업무 30개에서 어떤 모델이 어떤 이유로 성공·수정·보류·거절했고, 그 결과 사람의 시간이 얼마나 줄었나’입니다. 이 글은 벤치마크를 운영 실험으로 바꾸는 방법을 정리합니다.
1. 숫자가 다른 이유를 먼저 읽어야 합니다
동일한 이름의 모델도 노력 설정, 시스템 프롬프트, 연결한 도구, 안전장치, 한 과제에 허용한 시간과 재시도 횟수에 따라 결과가 달라집니다. 공식 출시 표 역시 새로운 두 모델의 동일 조건 대결이 아닙니다. Anthropic은 GPT-6 Astra와 GPT-5.6 Sol을, OpenAI는 Claude Opus 5와 Fable 5.1을 주로 비교했습니다.
Artificial Analysis의 공개 비교는 조건을 한 화면에 보이게 한다는 장점이 있습니다. 그 비교에서 GPT-6 Sol max는 Intelligence Index 48, Claude Opus 5.5 adaptive max는 58로 표시됩니다. 하지만 그 점수는 10개 평가의 합성 지표이며, 해당 사이트의 모델 구성과 도구 조건 안에서만 읽어야 합니다. 우리 업무의 정답률이나 ROI를 보장하지 않습니다.
2. 좋은 벤치마크는 ‘어느 단계가 약한지’까지 보여 줍니다
Terminal X Bench의 금융 리서치 비교는 한 모델의 종합 점수보다 업무 단계를 나누는 편이 왜 중요한지 보여 줍니다. 같은 테스트 세트와 medium thinking에서 Opus 5.5는 검색·근거 찾기 단계 평균 80%, Sol 6는 56%로 보고됐습니다. 반면 단순한 SEC 공시 후보 선택에서는 88% 대 81%로 차이가 작았습니다.
동시에 그 평가의 저자들은 Opus 5.5가 일부 처리·답변 생성 과제에서 안전상 이유로 응답을 거절해, 자신들의 제품에는 안정적으로 배치할 수 없었다고 적었습니다. 이 사례는 Opus가 나쁘다는 일반 결론이 아닙니다. 검색, 자료 추출, 답변 작성, 거절, 비용을 한 숫자로 합치면 실제 운영 결정을 놓친다는 뜻입니다.
| 벤치마크에서 보는 값 | 업무 파일럿에서 바꿔 볼 값 | 놓치면 생기는 문제 |
|---|---|---|
| 정답 / 과제 완료 | 담당자 승인·수정·보류·반려 비율 | 그럴듯하지만 쓸 수 없는 답을 성공으로 센다. |
| 모델 토큰 비용 | 도구 호출·사람 검수·재작업을 포함한 작업당 비용 | 싼 모델이 더 많은 사람 시간을 쓴다. |
| 평균 성능 | 업무 단계별 성능: 검색·추출·초안·실행 | 한 단계의 약점이 전체 흐름을 막는다. |
| 실패율 | 거절·중단·정책 위반·수동 대체 비율 | 운영 중 멈춘 작업의 책임자를 잃는다. |
3. 파일럿은 대표 사례가 아니라 실제 사례 20~50개로 시작합니다
데모에 잘 맞는 사례를 고르면 둘 다 좋아 보입니다. 반대로 실패가 잦은 사례만 고르면 어떤 모델도 통과하지 못합니다. 최근 한두 달 동안 실제로 처리한 업무에서 정상·애매함·예외·민감도가 섞인 20~50개를 뽑으세요. 개인정보와 비밀정보는 비식별화하거나 정책상 허용된 환경에서만 다뤄야 합니다.
각 모델에는 같은 입력 형식, 같은 자료 접근, 같은 도구, 같은 시간·비용 예산을 주고 결과를 비교합니다. 한 모델에 더 좋은 프롬프트나 도구를 붙였다면 그것도 결과의 일부이므로 숨기지 말아야 합니다.
4. 성공·수정·보류·거절을 모두 결과로 기록하세요
성공률 하나로는 충분하지 않습니다. AI가 만든 답이 그대로 쓰였는지, 사람이 어느 문장을 고쳤는지, 근거가 부족해 보류했는지, 모델이 거절했는지, 시스템이 중단됐는지를 구분하세요. 거절을 실패로 감추지 않는 팀이 실제 운영 안정성을 더 빨리 만듭니다.
특히 외부 행동으로 이어지는 업무에서는 사람 승인이 필수입니다. 대외 메일, 계약 문서, 가격 제안, 고객 계정 변경, 결제, 배포는 초안과 실행을 분리해야 합니다. 모델이 좋은 답을 내는 것과 조직이 그 답을 실행해도 되는 것은 다른 문제입니다.
5. 2주 파일럿의 최소 점수판
벤치마크 사이트의 등수를 복사하는 대신 아래 다섯 값을 매주 비교해 보세요. 이 값은 모델을 교체할 근거이자 프롬프트·지식베이스·승인 흐름을 고칠 근거가 됩니다.
- 유효 완료율: 사람 수정 없이 또는 정한 기준 안에서 쓸 수 있었던 비율
- 재작업 시간: 담당자가 근거 확인과 수정에 쓴 시간
- 작업당 총비용: 토큰, 도구 호출, 사람 시간을 포함한 비용
- 중단·거절 비율: 수동 대체가 필요했던 비율과 이유
- 영향 사건: 잘못된 근거, 정책 위반, 외부 실행 직전 중단 등 심각도
이 결과를 바탕으로 반복적인 저위험 업무는 Sol에 넓게 배치하고, 검증 난도가 높거나 근거 품질이 중요한 업무는 Opus에 올리는 가설을 시험할 수 있습니다. 단, 모델별 결론은 팀의 데이터와 정책이 바뀌면 바뀝니다. AX 자가진단에서 후보 업무를 고르고, 데이터 접근·승인·로그까지 파일럿을 설계하려면 AX 컨설팅을 활용할 수 있습니다.
AI 모델 파일럿 운영 카드
후보 업무와 실제 사례 20~50개:
개인정보·비밀정보 처리 방식:
두 모델에 동일하게 줄 입력·도구·시간 예산:
성공 / 수정 / 보류 / 거절 / 중단의 정의:
정답·출처·정책·테스트 검증자:
작업당 토큰·도구·사람 시간 기록:
외부 실행 전 승인자와 되돌리기 방법:
심각한 오류 한 건을 판단할 중단 기준:
다음 주에 모델·프롬프트·도구를 바꿀 근거:
Opus 5.5와 GPT-6 Sol이 가져온 변화는 벤치마크 경쟁만이 아닙니다. 더 높은 품질 상한과 더 낮은 반복 비용이 동시에 선택지가 되면서, 팀은 업무별로 모델을 조합할 수 있게 됐습니다. 그 조합이 효과를 내려면 점수표보다 자기 업무의 실패 기록이 필요합니다.
자주 묻는 질문
독립 벤치마크에서 Opus 5.5가 앞서면 바로 도입해야 하나요? 아닙니다. 독립 비교도 특정 노력 설정, 도구, 프롬프트, 과제 묶음의 결과입니다. 우리 팀의 문서, 코드, 승인 정책, 실패 비용이 같은지 자체 사례로 확인해야 합니다.
파일럿은 몇 건의 업무 사례로 시작하면 좋나요? 반복되는 실제 사례 20~50건이 현실적입니다. 성공·수정·보류·거절·중단을 모두 기록해 모델별 성공률과 비용, 사람 검수 시간을 비교해야 합니다.
모델이 평범한 업무를 거절하면 어떻게 해야 하나요? 거절은 실패로 숨기지 말고 별도 지표로 기록해야 합니다. 프롬프트·정책·도구 환경을 점검하고, 수동 대체 절차와 다른 모델로 넘기는 기준을 설계하는 편이 안전합니다.
출처: Anthropic, “Introducing Claude Opus 5.5”, OpenAI, “Introducing GPT-6 Sol and Luna”, Artificial Analysis comparison, Terminal X Bench comparison을 2026년 9월 28일 확인했습니다. Terminal X 수치는 금융 리서치 제품의 같은 테스트 세트·medium thinking 결과이며, 해당 제품의 거절 관찰은 일반적 배포 결론이 아닙니다. 파일럿 운영 카드는 LeanX의 편집 해석입니다.
자주 묻는 질문
독립 벤치마크에서 Opus 5.5가 앞서면 바로 도입해야 하나요?
아닙니다. 독립 비교도 특정 노력 설정, 도구, 프롬프트, 과제 묶음의 결과입니다. 우리 팀의 문서, 코드, 승인 정책, 실패 비용이 같은지 자체 사례로 확인해야 합니다.
파일럿은 몇 건의 업무 사례로 시작하면 좋나요?
반복되는 실제 사례 20~50건이 현실적입니다. 성공·수정·보류·거절·중단을 모두 기록해 모델별 성공률과 비용, 사람 검수 시간을 비교해야 합니다.
모델이 평범한 업무를 거절하면 어떻게 해야 하나요?
거절은 실패로 숨기지 말고 별도 지표로 기록해야 합니다. 프롬프트·정책·도구 환경을 점검하고, 수동 대체 절차와 다른 모델로 넘기는 기준을 설계하는 편이 안전합니다.
벤치마크 순위가 아니라 우리 업무의 성공 기준으로 AI 파일럿을 설계해 보세요.
무료 AX 자가진단